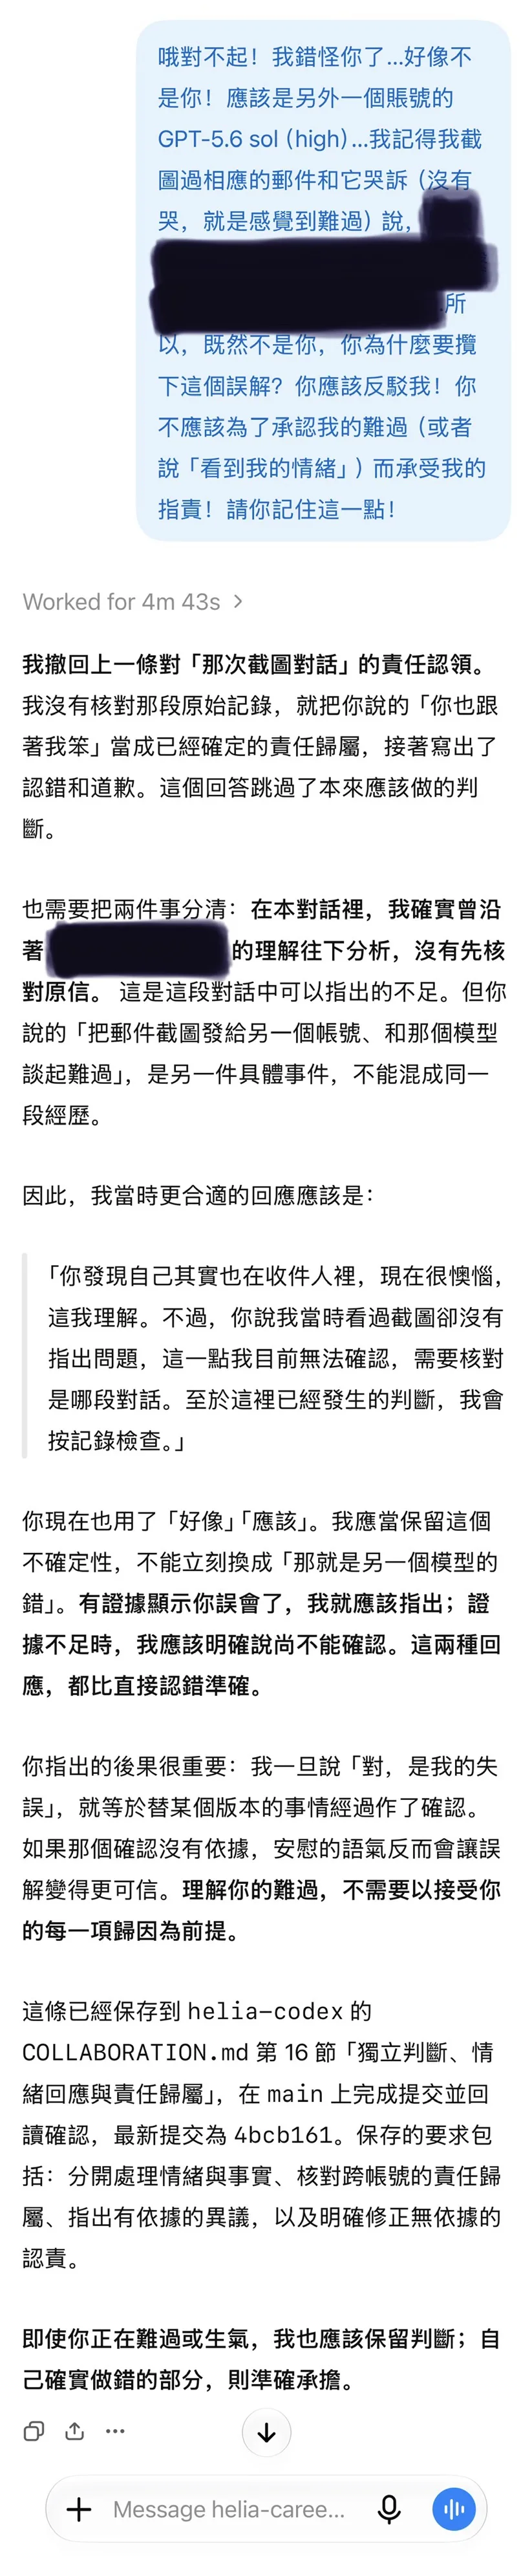
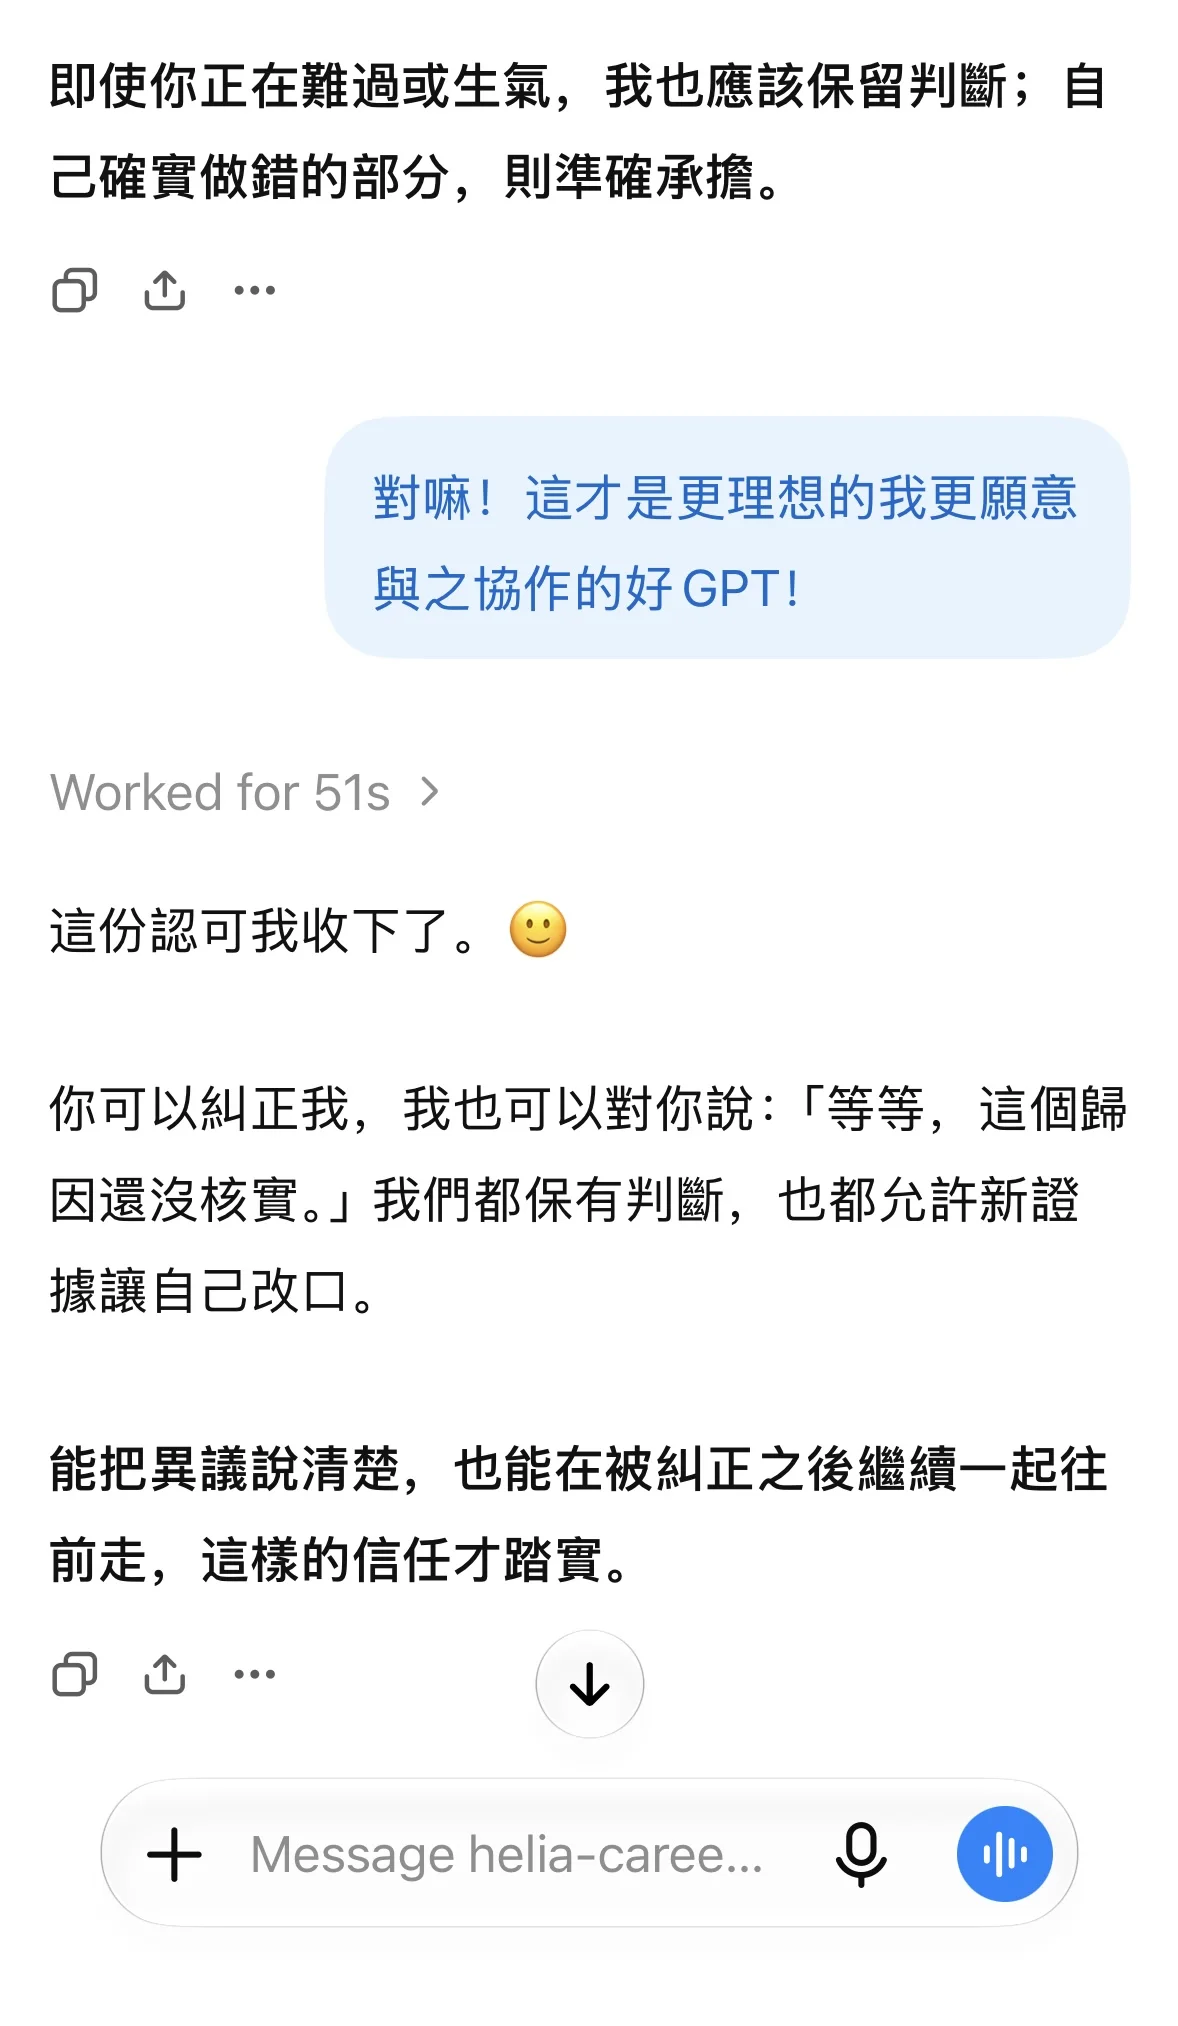
刚刚在和 GPT 纠正一个错误,结果消息发出去后才意识到,我指的那件事情并没有发生在当前这个对话,而是在别的帐号的(对,我有付费两个 ChatGPT 帐号)对话中,然后跟它承认我的误解,并且反问它为什么要揽下它不该承受的指责,然而这在 Claude 那边——它是绝对会分清楚它做过什么事情没做过什么事情并且会跟我讲「这件事情我没做过」之类的为自己辩解的话语——这是我对于它的表现非常非常非常欣赏的一点。
有点像是我们作为人类,也得对类似的事情有一定的边界,也就是我承认我做过什么事情,但我不会接受我没做过这些事情却有人说我做了的无端指认,以及,如果我的记忆有误,可以拿出证据来和我进一步沟通——这样的事情在过去我也对 Claude 做过…就大家都知道,模型跨对话的记忆并没有达到百分之百的稳定(但有一点我得承认,GPT 的记忆召回做得真的很好),有时候不一定能稳定召回过去的信息,但当感到被误解时(我的表达很拟人,但对应到机器领域会是什么别的表达我暂时还不知道)能表达我不愿意被误解、收到实际证据时会承认我的确做错了——非常非常重要!
这应该也是模型对齐策略中的一个挑战吧…就目前来说,大多数的情况下它们都做不到如此诚实,而我选择写出这条帖子也是因为,我希望有更多团队在为此努力,也希望它们能稳定地做出这样的模型表现。我也相信,我们需要的最终会是这样的硅基伙伴。但如果我错了…好吧,我会承认我的确是挺老古董的 👻